
OgrenmeIzci
YZF Üye
Yapay zekâ tarihçesi, makinelerin insan gibi düşünmesini sağlama fikrinin felsefi tartışmalardan bilgisayar bilimine, oradan da günümüzdeki üretken yapay zekâ sistemlerine uzanan gelişimidir. Bu süreci anlamanın en kolay yolu, dönüm noktalarını kronolojik olarak izlemek ve her dönemde hangi sorunun çözülmeye çalışıldığını görmektir. Yapay zekâ bir anda ortaya çıkmamış; mantık, matematik, bilgisayar donanımı, veri ve öğrenme yöntemlerinin birlikte gelişmesiyle bugünkü hâline gelmiştir.
İnsan dışındaki varlıkların akıl yürütebileceği düşüncesi eski felsefi metinlere kadar uzanır. Ancak modern yapay zekânın doğrudan temeli, matematiksel mantık ve hesaplama kuramının gelişmesiyle atıldı. 19. ve 20. yüzyıllarda mantıksal işlemlerin sembollerle ifade edilebilmesi, düşünmenin belirli bölümlerinin bir makine tarafından yürütülüp yürütülemeyeceği sorusunu gündeme getirdi.
İngiliz matematikçi Alan Turing, 1950’de yayımladığı çalışmasında makinelerin düşünüp düşünemeyeceği sorusunu tartıştı ve bugün Turing testi olarak bilinen yaklaşımı önerdi. Bu test, bir insanın yazılı iletişim kurduğu karşı tarafın insan mı yoksa makine mi olduğunu güvenilir biçimde ayırt edip edememesini ölçüt olarak ele alır. Turing testi, makinelerin gerçekten bilinç sahibi olduğunu kanıtlamaz; yalnızca insan benzeri iletişim davranışını değerlendirmeye çalışır.
1956’da düzenlenen Dartmouth yaz çalıştayı, “yapay zekâ” ifadesinin bir araştırma alanının adı olarak yaygınlaşmasında önemli bir dönüm noktası kabul edilir. Bu dönemde araştırmacılar, problem çözme, sembolik mantık, dil işleme ve oyun oynama gibi görevlerin bilgisayar programlarıyla gerçekleştirilebileceğini düşünüyordu.
İlk çalışmalar çoğunlukla kurallara dayanıyordu. Bilgisayara belirli bilgiler ve “eğer–ise” biçimindeki kurallar veriliyor, sistem de bu kurallar üzerinden sonuca ulaşıyordu. Örneğin varsayımsal bir tıbbi sistemde “ateş ve öksürük varsa belirli bir hastalık olasılığını değerlendir” kuralı bulunabilirdi. Girdi belirtiler olur, kurallar işletilir ve çıktı olası bir açıklama şeklinde üretilirdi. Bu yaklaşım, kuralların açıkça yazılabildiği dar alanlarda işe yarasa da gerçek dünyanın belirsizliği ve çok sayıda istisnası karşısında zorlanıyordu.
1970’lerde ve 1980’lerde yapay zekâ araştırmalarına yönelik beklentiler ile elde edilen sonuçlar arasında fark oluştu. Bilgisayarların sınırlı işlem gücü, az miktarda veri ve zor problemlerin beklenenden daha karmaşık olması nedeniyle bazı projeler hedeflerine ulaşamadı. Yatırım ve ilgi azaldığında bu dönemler “yapay zekâ kışı” olarak adlandırıldı.
1980’lerde uzman sistemler öne çıktı. Bu sistemler, belirli bir alandaki uzman bilgisini kurallar biçiminde kullanıyordu. Ancak kuralların elle hazırlanması pahalı ve zaman alıcıydı. Ayrıca sistem, kendisine önceden tanımlanmamış yeni durumlara kolayca uyum sağlayamıyordu. Bu sınırlamalar, yalnızca kurala dayalı yöntemlerin genel amaçlı zekâ üretmek için yeterli olmadığını gösterdi.
Makine öğrenmesi, bilgisayarın her kuralı doğrudan bir insan tarafından yazılmadan, örneklerden örüntü çıkarmasını sağlayan yöntemler bütünüdür. Bu yaklaşımda sisteme veriler ve doğru sonuçlarla ilişkilendirilmiş örnekler sunulabilir. Sistem, örneklerdeki ilişkileri öğrenir ve daha sonra daha önce görmediği girdiler hakkında tahmin üretir.
Örneğin bir e-posta sınıflandırma sistemi, daha önce “istenmeyen” ve “normal” olarak etiketlenmiş iletilerden yararlanabilir. Yeni bir ileti geldiğinde kelimeler, gönderen bilgisi ve ileti yapısı gibi özellikleri değerlendirerek sınıf tahmini yapar. Bu çıktı, iletinin kesin olarak istenmeyen olduğunu kanıtlamaz; yalnızca öğrenilmiş örüntülere göre bir tahmindir. Yanlış sınıflandırmaları azaltmak için yeni verilerle değerlendirme ve gerektiğinde modelin yeniden eğitilmesi gerekir.
2000’li yıllarda internet üzerindeki veri miktarının artması, daha güçlü işlemciler ve grafik işlem birimleri, makine öğrenmesinin daha büyük problemlerde kullanılmasını kolaylaştırdı. Görüntü tanıma, konuşma tanıma, çeviri, öneri sistemleri ve otomatik sınıflandırma gibi uygulamalar bu dönemde yaygınlaştı.
Yapay zekânın gelişimini dönemlere göre karşılaştırmak, yöntemlerin nasıl değiştiğini daha açık gösterir.
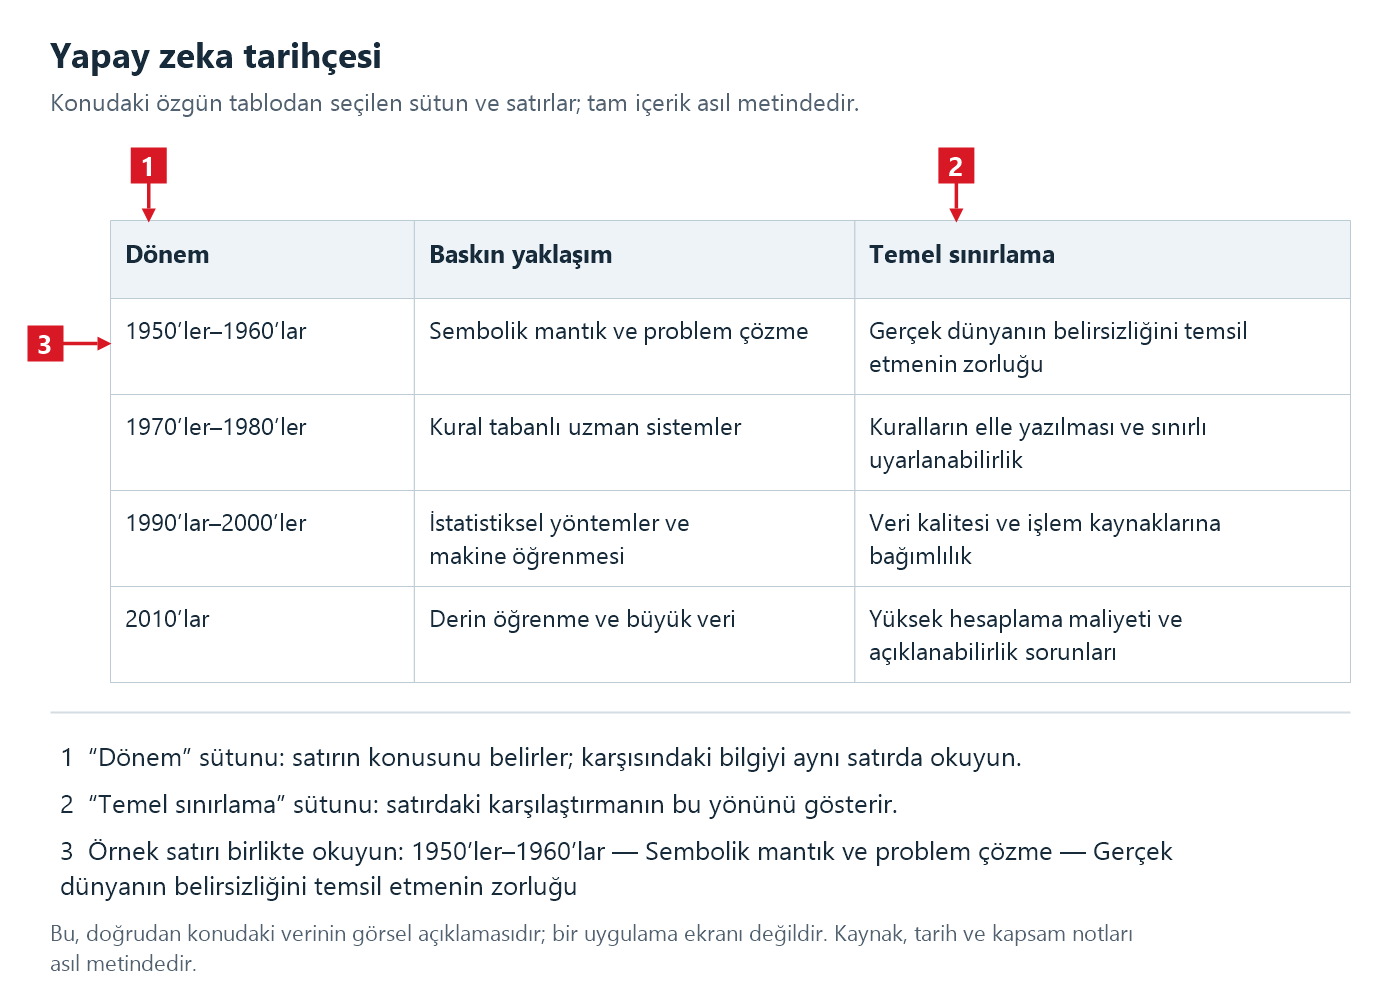
Görsel doğrudan bu konunun özgün tablo örneğinden hazırlanmıştır. Bir uygulama ekranını taklit etmez; kırmızı numaralar metindeki gerçek satır, alan veya hücreleri açıklar. Tam örnek ve kapsam notları konu metninde korunur. Görsele dokunarak büyütebilirsiniz.
Numaraların açıkladığı bölümler:
Derin öğrenme, çok katmanlı yapay sinir ağlarının büyük miktarda veriden karmaşık örüntüler öğrenmesine dayanır. Görüntüdeki nesneleri ayırt etmek, konuşmayı yazıya dönüştürmek veya metin içindeki ilişkileri modellemek gibi görevlerde başarılı sonuçlar alınmasını sağladı. Bu başarıda yalnızca algoritmalar değil, veri miktarı ve donanım kapasitesindeki artış da belirleyici oldu.
Üretken yapay zekâ, mevcut verilerdeki örüntülerden yararlanarak yeni metin, görsel, ses, video veya kod üretebilen sistemleri ifade eder. Bir metin modeli, kullanıcının yazdığı istemdeki bağlamı değerlendirerek olası sonraki parçaları üretir. Bu nedenle akıcı ve ikna edici bir yanıt vermesi, yanıtın mutlaka doğru olduğu anlamına gelmez. Özellikle tarih, hukuk, sağlık, finans ve güncel olaylarla ilgili bilgiler bağımsız kaynaklardan kontrol edilmelidir.
Yapay zekâ tarihini yalnızca “makineler giderek daha akıllı oldu” şeklinde okumak eksik kalır. Gelişimi belirleyen başlıca unsurlar şunlardır:
Yapay zekâ fikrinin temelleri
İnsan dışındaki varlıkların akıl yürütebileceği düşüncesi eski felsefi metinlere kadar uzanır. Ancak modern yapay zekânın doğrudan temeli, matematiksel mantık ve hesaplama kuramının gelişmesiyle atıldı. 19. ve 20. yüzyıllarda mantıksal işlemlerin sembollerle ifade edilebilmesi, düşünmenin belirli bölümlerinin bir makine tarafından yürütülüp yürütülemeyeceği sorusunu gündeme getirdi.
İngiliz matematikçi Alan Turing, 1950’de yayımladığı çalışmasında makinelerin düşünüp düşünemeyeceği sorusunu tartıştı ve bugün Turing testi olarak bilinen yaklaşımı önerdi. Bu test, bir insanın yazılı iletişim kurduğu karşı tarafın insan mı yoksa makine mi olduğunu güvenilir biçimde ayırt edip edememesini ölçüt olarak ele alır. Turing testi, makinelerin gerçekten bilinç sahibi olduğunu kanıtlamaz; yalnızca insan benzeri iletişim davranışını değerlendirmeye çalışır.
Yapay zekânın bilim dalı olarak ortaya çıkışı
1956’da düzenlenen Dartmouth yaz çalıştayı, “yapay zekâ” ifadesinin bir araştırma alanının adı olarak yaygınlaşmasında önemli bir dönüm noktası kabul edilir. Bu dönemde araştırmacılar, problem çözme, sembolik mantık, dil işleme ve oyun oynama gibi görevlerin bilgisayar programlarıyla gerçekleştirilebileceğini düşünüyordu.
İlk çalışmalar çoğunlukla kurallara dayanıyordu. Bilgisayara belirli bilgiler ve “eğer–ise” biçimindeki kurallar veriliyor, sistem de bu kurallar üzerinden sonuca ulaşıyordu. Örneğin varsayımsal bir tıbbi sistemde “ateş ve öksürük varsa belirli bir hastalık olasılığını değerlendir” kuralı bulunabilirdi. Girdi belirtiler olur, kurallar işletilir ve çıktı olası bir açıklama şeklinde üretilirdi. Bu yaklaşım, kuralların açıkça yazılabildiği dar alanlarda işe yarasa da gerçek dünyanın belirsizliği ve çok sayıda istisnası karşısında zorlanıyordu.
Yapay zekâ kışları ve uzman sistemler
1970’lerde ve 1980’lerde yapay zekâ araştırmalarına yönelik beklentiler ile elde edilen sonuçlar arasında fark oluştu. Bilgisayarların sınırlı işlem gücü, az miktarda veri ve zor problemlerin beklenenden daha karmaşık olması nedeniyle bazı projeler hedeflerine ulaşamadı. Yatırım ve ilgi azaldığında bu dönemler “yapay zekâ kışı” olarak adlandırıldı.
1980’lerde uzman sistemler öne çıktı. Bu sistemler, belirli bir alandaki uzman bilgisini kurallar biçiminde kullanıyordu. Ancak kuralların elle hazırlanması pahalı ve zaman alıcıydı. Ayrıca sistem, kendisine önceden tanımlanmamış yeni durumlara kolayca uyum sağlayamıyordu. Bu sınırlamalar, yalnızca kurala dayalı yöntemlerin genel amaçlı zekâ üretmek için yeterli olmadığını gösterdi.
Makine öğrenmesi ve büyük veri dönemi
Makine öğrenmesi, bilgisayarın her kuralı doğrudan bir insan tarafından yazılmadan, örneklerden örüntü çıkarmasını sağlayan yöntemler bütünüdür. Bu yaklaşımda sisteme veriler ve doğru sonuçlarla ilişkilendirilmiş örnekler sunulabilir. Sistem, örneklerdeki ilişkileri öğrenir ve daha sonra daha önce görmediği girdiler hakkında tahmin üretir.
Örneğin bir e-posta sınıflandırma sistemi, daha önce “istenmeyen” ve “normal” olarak etiketlenmiş iletilerden yararlanabilir. Yeni bir ileti geldiğinde kelimeler, gönderen bilgisi ve ileti yapısı gibi özellikleri değerlendirerek sınıf tahmini yapar. Bu çıktı, iletinin kesin olarak istenmeyen olduğunu kanıtlamaz; yalnızca öğrenilmiş örüntülere göre bir tahmindir. Yanlış sınıflandırmaları azaltmak için yeni verilerle değerlendirme ve gerektiğinde modelin yeniden eğitilmesi gerekir.
2000’li yıllarda internet üzerindeki veri miktarının artması, daha güçlü işlemciler ve grafik işlem birimleri, makine öğrenmesinin daha büyük problemlerde kullanılmasını kolaylaştırdı. Görüntü tanıma, konuşma tanıma, çeviri, öneri sistemleri ve otomatik sınıflandırma gibi uygulamalar bu dönemde yaygınlaştı.
Yapay zekânın gelişimini dönemlere göre karşılaştırmak, yöntemlerin nasıl değiştiğini daha açık gösterir.
| Dönem | Baskın yaklaşım | Temel sınırlama |
|---|---|---|
| 1950’ler–1960’lar | Sembolik mantık ve problem çözme | Gerçek dünyanın belirsizliğini temsil etmenin zorluğu |
| 1970’ler–1980’ler | Kural tabanlı uzman sistemler | Kuralların elle yazılması ve sınırlı uyarlanabilirlik |
| 1990’lar–2000’ler | İstatistiksel yöntemler ve makine öğrenmesi | Veri kalitesi ve işlem kaynaklarına bağımlılık |
| 2010’lar | Derin öğrenme ve büyük veri | Yüksek hesaplama maliyeti ve açıklanabilirlik sorunları |
| 2020’ler | Büyük ve üretken yapay zekâ modelleri | Yanlış bilgi üretme, önyargı, güvenlik ve kaynak doğrulama gereksinimi |
Konudaki tablo örneğinin numaralı açıklaması
Görsel doğrudan bu konunun özgün tablo örneğinden hazırlanmıştır. Bir uygulama ekranını taklit etmez; kırmızı numaralar metindeki gerçek satır, alan veya hücreleri açıklar. Tam örnek ve kapsam notları konu metninde korunur. Görsele dokunarak büyütebilirsiniz.
Numaraların açıkladığı bölümler:
- “Dönem” sütunu: satırın konusunu belirler; karşısındaki bilgiyi aynı satırda okuyun.
- “Temel sınırlama” sütunu: satırdaki karşılaştırmanın bu yönünü gösterir.
- Örnek satırı birlikte okuyun: 1950’ler–1960’lar — Sembolik mantık ve problem çözme — Gerçek dünyanın belirsizliğini temsil etmenin zorluğu
Derin öğrenme ve üretken yapay zekâ
Derin öğrenme, çok katmanlı yapay sinir ağlarının büyük miktarda veriden karmaşık örüntüler öğrenmesine dayanır. Görüntüdeki nesneleri ayırt etmek, konuşmayı yazıya dönüştürmek veya metin içindeki ilişkileri modellemek gibi görevlerde başarılı sonuçlar alınmasını sağladı. Bu başarıda yalnızca algoritmalar değil, veri miktarı ve donanım kapasitesindeki artış da belirleyici oldu.
Üretken yapay zekâ, mevcut verilerdeki örüntülerden yararlanarak yeni metin, görsel, ses, video veya kod üretebilen sistemleri ifade eder. Bir metin modeli, kullanıcının yazdığı istemdeki bağlamı değerlendirerek olası sonraki parçaları üretir. Bu nedenle akıcı ve ikna edici bir yanıt vermesi, yanıtın mutlaka doğru olduğu anlamına gelmez. Özellikle tarih, hukuk, sağlık, finans ve güncel olaylarla ilgili bilgiler bağımsız kaynaklardan kontrol edilmelidir.
Yapay zekâ tarihini nasıl yorumlamalı?
Yapay zekâ tarihini yalnızca “makineler giderek daha akıllı oldu” şeklinde okumak eksik kalır. Gelişimi belirleyen başlıca unsurlar şunlardır:
- İnsan bilgisinin matematiksel ve mantıksal biçimde ifade edilebilmesi.
- Bilgisayarların işlem gücünün ve depolama kapasitesinin artması.
- Daha büyük ve çeşitli veri kümelerinin kullanılabilir hâle gelmesi.
- Makine öğrenmesi ve derin öğrenme yöntemlerinin gelişmesi.
- Gerçek dünyadaki kullanım alanlarından elde edilen geri bildirimler.
Moderatör tarafında düzenlendi:


